OpenZhenZhen AI 提示词画廊 · MiniMax H3 · video
托盘带杯与杯垫同步半转身
Tray with Cup and Coaster in Synchronized Half-Turn
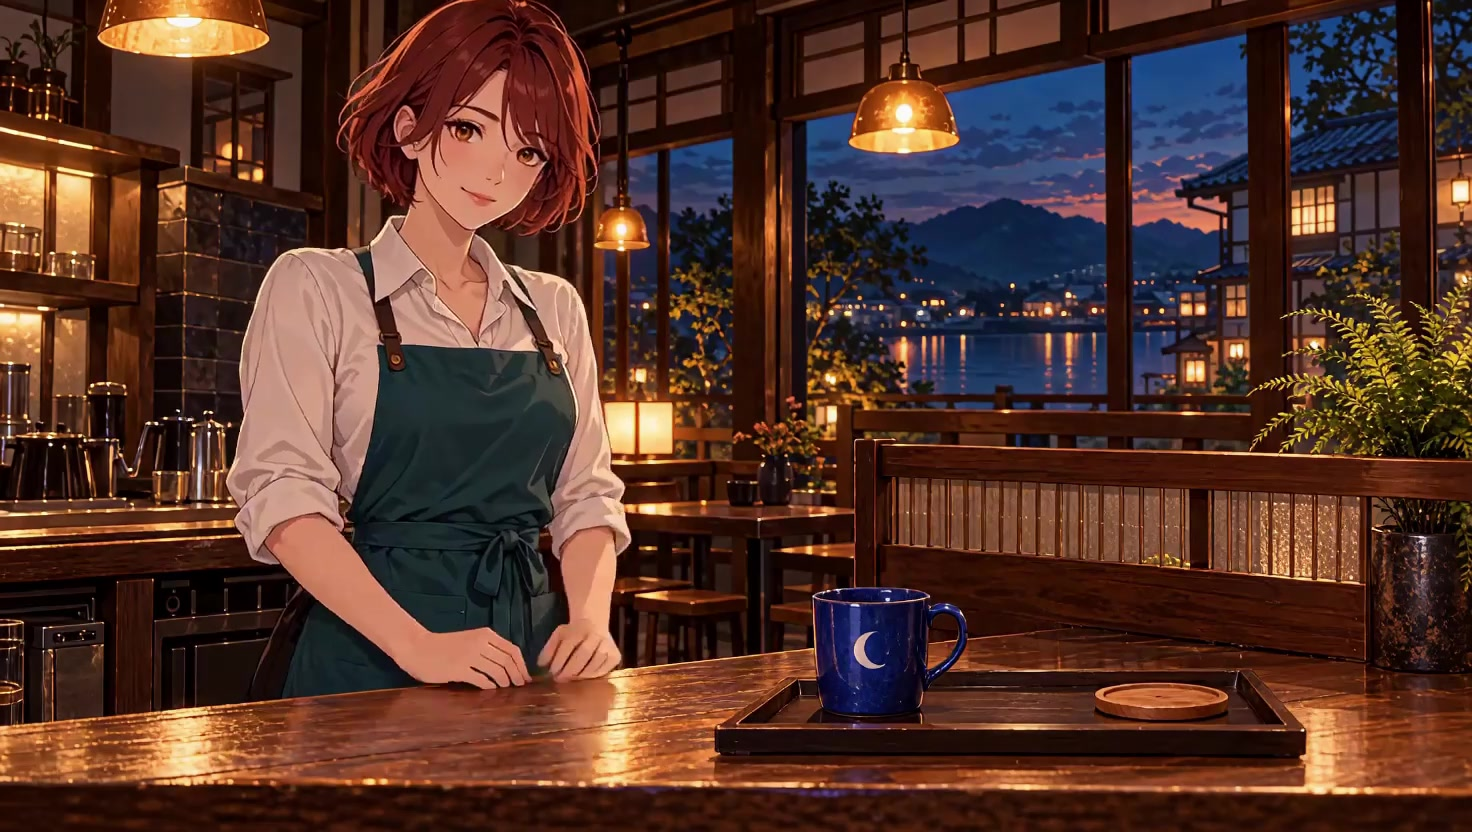
8秒连续动作示例:托盘带杯与杯垫同步半转身。
提示词 / Prompt
中文提示词
8秒连续镜头,动漫电影风格。一名栗棕短发、穿蓝绿色围裙的成年咖啡师,只有一只带白月牙的钴蓝杯、一个托盘、一个木杯垫和一个低隔板。参考图1定义唯一场景的构图和角色身份;参考图2仅为同一地点的环境参考;参考图3是图1中同一件主要道具的设计近景,不是第二件道具。将三图组合成一个连贯场景,不能做成三联画。只使用动作中明确规定的物体数量。她端起载有唯一正立杯子与唯一杯垫的托盘,身体与保持水平的托盘一起旋转半圈,再将整个托盘放回台面。杯子和杯垫全程随托盘移动,始终支撑在托盘上表面。摄影机固定为中广角四分之三视角,使相关双手、道具、接触面与最终状态始终可见。以自然速度连续完整展示动作,不剪切、不转场、不插入其他画面、不增加表演者或魔法效果。遵守实体边界与正常物理支撑。尽快开始指定动作,结束状态短暂停留。无字幕、UI、水印或画面标签。适当而安静的室内环境声和自然接触声,无对白、无背景音乐。
English prompt
summary: [reference generation] One continuous 8-second shot in anime film style. One adult auburn-bob barista in a teal apron; one cobalt mug with one white crescent, one tray, one wooden coaster, one low divider. reference_roles: Picture 1 defines the SINGLE scene composition and character identity. Picture 2 is environment-only reference for that SAME location. Picture 3 is a close-up design reference for the SAME hero object visible in Picture 1, NOT a second object. Combine these references into one coherent scene, not three panels. Use only the object counts explicitly stated in the action. detailed_description: She lifts the tray carrying the single upright mug and the one coaster, rotates her body and the level tray a half-turn together, then sets the whole tray back on the counter. The mug and coaster travel with the tray and remain supported on its top throughout. Camera: locked medium-wide three-quarter view keeping relevant hands, props, contact surfaces and end state visible. Show the entire action continuously at natural speed; no cuts, transitions, cutaways, extra performers or magical effects. Respect solid object boundaries and normal physical support. Start the requested action promptly and hold the final state briefly. No subtitles, UI, watermarks or on-screen labels. overall_soundscape: Quiet appropriate room ambience and natural contact sounds; no speech. non_diegetic_music: None.
主题与风格
探索更多图片和视频提示词 · 生成图片 · 生成视频 · 在 AI 画布中创作
相关作品
- 哈士奇111
subject_definitions: <Subject 1> 是本片唯一的宠物主角 — FACE from <Picture 1>(哈士奇雪橇犬,冰蓝色眼睛,黑色鼻头,黑白双色、头顶黑色面罩纹、灰黑鞍部、白脸白胸白四肢,蓬松双层毛、体态骨架匀称结实,气质活泼)。只参考 <Picture 1> 的外观(五官、毛色、花纹、体型),不使用 <Picture 1> 的背景、场景与构图;视频全程保持与 <Picture 1> 外观完全一致。 summary: [reference generation] 0-5s 静谧微距张力;5-9s 爪部微距切全景;9-15s 摇臂升空+逆光剪影谢幕。主角全程
- 哈士奇
subject_definitions: <Subject 1> 是本片唯一的宠物主角 — FACE from <Picture 1>(哈士奇雪橇犬,冰蓝色眼睛,黑色鼻头,黑白双色、头顶黑色面罩纹、灰黑鞍部、白脸白胸白四肢,蓬松双层毛、体态骨架匀称结实,气质活泼)。只参考 <Picture 1> 的外观(五官、毛色、花纹、体型),不使用 <Picture 1> 的背景、场景与构图;视频全程保持与 <Picture 1> 外观完全一致。 summary: [reference generation] 0-4s 鼻头超微距视觉钩子;4-9s 变速极速拉出+3D环绕;9-15s 0.4x呼吸感定格
- 西格玛男人修仙
用了吃猪侠那个跑30秒的工作流 所以可以跑20秒视频
- 女孩真人感测试
**【参考图像锚定】** 图像 1 是 [年轻女性],保留参考图中的面部特征、精致妆容、浅金色长直发与空气刘海、简约白色上衣、脖颈细金链与小巧金坠吊坠,及整体外貌。人物仅锚人物本身,场景按下文文字重建,不得沿用图内任何构图或背景细节。 **【分镜】** **人物初始站位与空间关系**:夜晚路灯下,她站在街边一盏路灯正下方偏前的位置,手持手机以真实前置摄像头自拍视角拍摄,画面从胸以上的中近景开始,镜头随她的手持动作运动。头顶路灯洒下柔和的暖白光池,从上方偏正前照亮她的脸 —— 额头、鼻梁、颧骨受光,鼻下与眼窝投下朝下的柔影;浅金发顶和颊边碎发被灯光勾出一圈暖色轮廓光,发丝末梢泛一点暖亮的金;
- H3单采,7秒打斗测试
integrated_multimodal_description: (本段为极度硬核的高速CG兵器交锋。禁用2D动漫渲染。画面中只有加雷斯和洛恩两人。加雷斯在连续攻击中开口嘲讽,洛恩全程嘴唇紧闭死扛。) [Shot1] 0-2.5s, Unreal Engine 5 render, hyper-realistic, fast-paced sword fight, dynamic camera tracking. A muscular man in heavy red-black iron armor (Gareth) swings a massive greatsword downward
- H3爆裂冲击帧之【闪电箭】
输入邀请码:rh-v1631 领1000RH币,每天登录还有100币 H3满血无损!正面对标SD2.0 全网最干净方便的空间折叠工作流,去除繁复连线、虚空桥接+空间折叠; B站主页:https://space.bilibili.com/111985620/lists?sid=7895659&spm_id_from=333.788.0.0 youtube主页:https://www.youtube.com/@%E5%90%83%E7%8C%AA%E4%BE%A0233